Twee meetdiensten, dezelfde klant, dezelfde dag. De ene rapporteert een vermeldingspercentage van 8 procent, de andere 40 procent. Allebei kunnen technisch kloppen.
Dat verschil is geen fout. Het is het voorspelbare gevolg van een markt waarin ruim twintig aanbieders meetdiensten verkopen zonder gedeelde definitie van wat een vermelding is, wat een citatie is, of wanneer een uitkomst betrouwbaar genoeg is om beleid op te baseren.
Sinds 3 augustus 2026 bestaat die gedeelde definitie wel. Het IAB publiceerde Measuring Visibility in the AI Era, het eerste sectorbrede framework voor het meten van AI-zichtbaarheid. Het levert drie dingen: een metrische hierarchie in vier lagen, een tweedeling in meetkwaliteit, en een verplichte openbaarmakingsset waarmee je als afnemer de methode van een aanbieder kunt beoordelen.
De kern: AI-zichtbaarheid is geen positie maar een verdeling. Je schat haar door een vooraf vastgelegde vragenset herhaald voor te leggen aan meerdere generatieve systemen, en per antwoord vast te leggen of, waar en in welke context een merk voorkomt.
Dit artikel behandelt de inhoud van die standaard, de statistische randvoorwaarden waaronder de metrics interpreteerbaar zijn, en wat het betekent voor meting in de Nederlandse markt.
Waarom twee diensten verschillende cijfers geven
Tot augustus 2026 kende deze markt geen gedeelde definities. Het IAB stelt vast dat meer dan twintig aanbieders meetdiensten verkopen, elk met een eigen methodologie, en dat die diensten materieel verschillende uitkomsten produceren voor hetzelfde merk in dezelfde categorie. Naar schatting van het IAB meet 16 procent van de merken AI-zichtbaarheid systematisch.
De divergentie ontstaat stroomopwaarts: in keuzes over de vragenset, het aantal herhalingen, de platformselectie, de geografische herkomst van de query en de vraag wat je precies een vermelding noemt. Wanneer twee onderzoekers hetzelfde woord voor verschillende operationalisaties gebruiken, is verschil in uitkomst het verwachte resultaat, niet het uitzonderlijke.
De schaal waarop dit speelt is niet klein. ChatGPT heeft meer dan 900 miljoen wekelijkse gebruikers. Google AI Overviews bereiken meer dan 2,5 miljard gebruikers per maand en verschijnen bij bijna de helft van alle zoekopdrachten. Voor Nederland rapporteert SeniorWeb een ChatGPT-penetratie van 60 procent, tegenover 24 procent voor Copilot en 20 procent voor Gemini.
Wat het framework wel en niet doet
Het framework is normatief over definities en openbaarmaking, en uitdrukkelijk niet over aanbieders en gereedschap. Het beoordeelt geen leveranciers, schrijft geen tools voor en levert zelf geen meetsysteem.
De afbakening is beperkt tot organische, onbetaalde zichtbaarheid. Optimalisatiemethodiek valt erbuiten, net als betaalde plaatsing en commerce-attributie. Het IAB signaleert wel dat organisch en betaald steeds vaker op hetzelfde antwoordoppervlak samenvallen, en dat een merk organisch geciteerd kan worden terwijl het in datzelfde antwoord een betaalde plaatsing heeft. Attributie krijgt een eigen framework.
Het document bevat daarnaast een aparte metricset voor uitgevers, onder meer Citation Decay Rate en Content Utilization Rate. Die blijft hier buiten beschouwing, omdat ze een ander doel dient: het onderbouwen van licentieonderhandelingen met AI-platforms.
Wat je eigenlijk meet
Voordat de metrics bruikbaar zijn, moeten drie dingen expliciet zijn: wat wordt geschat, uit welke steekproef, en met welke betrouwbaarheid.
De grootheid zelf is niet waarneembaar
Wat een merk werkelijk aan zichtbaarheid heeft binnen het universum van vragen dat gebruikers stellen, is niet meetbaar. Geen enkele partij kan private AI-gesprekken observeren. Wat een meetprogramma produceert is een schatting van een parameter binnen een geconstrueerd steekproefkader.
Dat kader is bovendien geen aselecte steekproef. De verzameling mogelijke prompts is in de praktijk onbegrensd, en een aanbieder selecteert daaruit doelgericht. Elke gerapporteerde zichtbaarheidsscore is dus een schatting binnen een doelgerichte steekproef, geen schatting van een populatieparameter in de klassieke zin. Dat maakt de uitkomst niet waardeloos, maar wel gebonden aan de vragenset die haar voortbracht. Twee scores uit verschillende vragensets zijn strikt genomen schattingen van verschillende grootheden.
De praktische consequentie: bij vergelijking over tijd moet de vragenset bevroren zijn. Pas je de set aan nadat je de resultaten hebt gezien, dan meet je je eigen redactie in plaats van het merk.
Betrouwbaarheid is niet hetzelfde als validiteit
Betrouwbaarheid gaat over reproduceerbaarheid: geeft herhaling van dezelfde procedure vergelijkbare uitkomsten? Dat is een functie van het aantal herhalingen en de spreiding daartussen.
Validiteit gaat over de vraag of de vragenset en de detectielogica meten wat je beoogt te meten. Een vragenset met uitstekende reproduceerbaarheid maar een scheve constructie levert precieze schattingen van de verkeerde grootheid. Het IAB benoemt dit expliciet: transparantie over de vragenset is een kwaliteitsdimensie, niet alleen een openbaarmakingsplicht.
Daarmee ligt de volgorde vast. Eerst validiteit, dan pas precisie. Precisie zonder validiteit is een zelfverzekerd verkeerd getal.
De uitkomst is binomiaal, en dat heeft gevolgen
Per prompt en per platform is de uitkomst per run binair: het merk wordt genoemd of niet. Een run is dus een Bernoulli-trekking. Over n runs is het aantal vermeldingen binomiaal verdeeld met parameter p, het onbekende ware vermeldingspercentage voor die prompt op dat platform.
Hieruit volgt meteen dat een enkelvoudige waarneming geen schatting met bruikbare precisie oplevert. Bij een waar percentage van 0,30 is de kans om in tien trekkingen exact drie vermeldingen te zien beperkt, en de kans op een uitkomst die minstens tien procentpunt afwijkt aanzienlijk.
Voor intervalschatting bij proporties zijn Wald-intervallen ongeschikt bij kleine n en bij waarden dicht bij 0 of 1. Het Wilson score-interval is hier de aangewezen methode: het gedraagt zich stabiel bij kleine steekproeven en bij extreme proporties, precies waar een merk in nul of in alle runs voorkomt. Enkele aanbieders passen dit inmiddels toe.
Runs zitten genest, en dat kost precisie
Runs zitten genest binnen prompts, prompts binnen platforms en platforms binnen markten. Waarnemingen binnen dezelfde prompt zijn gecorreleerd: sommige prompts leveren zeer stabiele merklijsten op, andere vrijwel niet.
Het gevolg is dat het ruwe aantal waarnemingen de precisie overschat. De relevante grootheid is de effectieve steekproefomvang, die daalt naarmate de intraclass-correlatie stijgt. MaxAEO rapporteert waarden per engine tussen ongeveer 0,44 en 0,73. Praktisch betekent dat: een opzet die op het ene platform een halve bandbreedte van vijf procentpunt haalt, haalt dat op een ander platform niet.
Hetzelfde onderzoek documenteert flinke heterogeniteit tussen prompts. De standaardafwijking van de stabiliteit binnen een campagne ligt rond 0,30, waarbij sommige prompts bijna perfect consistent zijn over runs en andere vrijwel volledig wisselen. Aggregeren over prompts zonder die spreiding te rapporteren verbergt informatie die je operationeel kunt gebruiken: instabiele prompts zijn precies de prompts waar interventie het meeste kan opleveren.
Daaruit volgt een ontwerpregel. Bij een vast meetbudget levert spreiding over meer platforms een set van meerdere imprecieze schattingen op, terwijl concentratie op een platform een verdedigbare schatting oplevert. Platforms toevoegen verdient pas overweging nadat het eerste platform de gewenste precisie haalt.
De vier lagen: Presence, Prominence, Portrayal, Persuasion
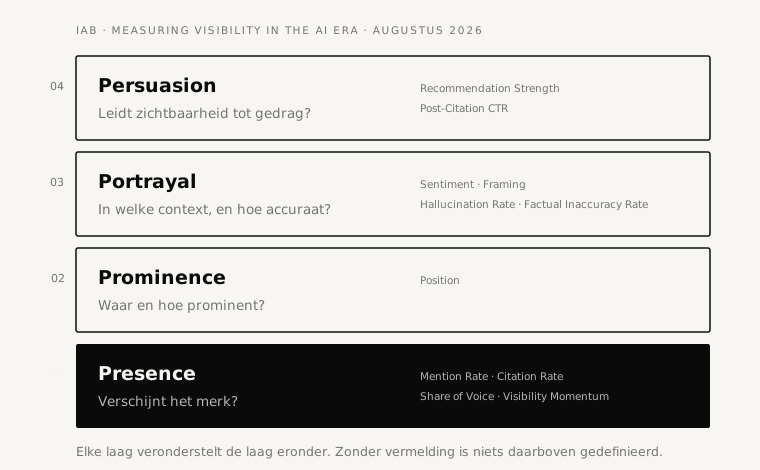
Het IAB ordent alle merkmetrics in vier lagen met een causale volgorde. Elke laag veronderstelt de laag eronder.
Presence: verschijnt het merk
Mention Rate = antwoorden met merkvermelding / totaal aantal antwoorden
De fundamentele metric. Het IAB benadrukt dat de uitkomst gevoelig is voor de samenstelling van de vragenset, en dat verschillende sets systematisch verschillende percentages opleveren. De metric is alleen interpreteerbaar in combinatie met de opgave van die set.
Citation Rate = antwoorden met citatie naar het merk / totaal aantal antwoorden
Een citatie is een gelinkte verwijzing, of een verwijzing waarin de bron bij naam wordt genoemd. Impliciete citaties, waarbij inhoud kennelijk aan een bron is ontleend zonder toeschrijving, vallen er uitdrukkelijk buiten omdat ze niet consistent meetbaar zijn over platforms heen.
Mention Rate meet of er over je gesproken wordt. Citation Rate meet of er op je gesteund wordt. Het verschil tussen die twee is zelf een signaal: het laat zien in hoeverre platforms jouw eigen domein als gezaghebbende bron behandelen, in plaats van alleen te herhalen wat derden over je schrijven.
Share of Voice = merkvermeldingen / totale merkvermeldingen binnen de gedefinieerde categorie
Hiervoor bestaat geen gestandaardiseerde formule. HubSpot, Semrush en Profound publiceren aantoonbaar verschillende operationalisaties. Semrush verdisconteert naast frequentie ook de positie binnen het antwoord, en voor ChatGPT bovendien het zoekvolume van het onderwerp.
Het IAB verplicht daarom twee openbaarmakingen die de uitkomst rechtstreeks bepalen: de afbakening van de concurrentiecategorie, en de bepaling van het totale vermeldingsuniversum binnen die set. Een Share of Voice zonder opgegeven noemer is niet interpreteerbaar.
Co-mention is geen zelfstandige metric maar een analytische lens op dezelfde data: met welke merken verschijn je consistent samen? Dat legt de concurrentieset bloot die het model impliciet hanteert, en die wijkt stelselmatig af van de set die een bedrijf zelf zou noemen. Voor positioneringsonderzoek is dit een van de informatiefste uitkomsten die er zijn.
Visibility Momentum is de procentuele verandering in Mention Rate of Share of Voice tussen meetperioden. De metric is kwetsbaar voor modelupdates die de nullijn verschuiven zonder dat het merk iets deed. Het IAB verplicht aanbieders te melden of trenddata na platformwijzigingen opnieuw is gebaseline’d. Zonder die opgave is de reeks niet interpreteerbaar.
Prominence: waar en hoe prominent
Position meet de plaats van het merk in het antwoord zoals de gebruiker het gerenderd ziet, niet in de ruwe modeloutput. De operationalisatie omvat: is het merk de eerst genoemde entiteit, wat is de rangorde bij meerdere merken, is het een zelfstandige aanbeveling of een van de opties, wat is de afstand tot het begin van het antwoord, en hoeveel verwijzingen staan er binnen een antwoord.
Bij lijstvormige antwoorden is dat eenduidig. Bij narratieve antwoorden bestaat geen universele methode, en moeten aanbieders hun keuze toelichten. Een tweede vrijheidsgraad is de meeteenheid zelf: het volledige gerenderde antwoord inclusief ingeklapte delen, een screenshot, of alleen wat bij eerste weergave in beeld staat. Die keuze verandert de uitkomst systematisch en hoort dus expliciet te zijn.
Portrayal: in welke context, en hoe accuraat
Sentiment classificeert de beschrijving als positief, neutraal of negatief. Het IAB is expliciet over de beperkte betrouwbaarheid: bij aanbevelings- en koopvragen domineert neutrale, beschrijvende taal, en classificatie is onbetrouwbaar bij genuanceerd of vergelijkend taalgebruik. De metric is het meest informatief bij informatieve vragen. Aanbieders moeten hun classificatiemethodiek, taxonomie en accuratesse-ijking publiceren.
Framing legt de contextuele positionering vast: marktleider, goedkoop alternatief, verouderde optie, nichespecialist, of ronduit in de verkeerde categorie geplaatst. Framing heeft vaak grotere commerciele gevolgen dan sentiment, want verkeerd geplaatst worden is een ander probleem dan negatief besproken worden.
Hallucination Rate = gehallucineerde vermeldingen / totale vermeldingen, per platform
Een gehallucineerde vermelding is een associatie, eigenschap of typering zonder grondslag in enige onderliggende bron, of toegeschreven aan een bestaande bron die de bewering niet ondersteunt. Dat is een kwaliteitsprobleem van het platform.
Factual Inaccuracy Rate = feitelijk onjuiste vermeldingen / totale vermeldingen, per platform
Hier klopt de vermelding wel, maar hangt er onjuiste informatie aan: verouderde prijzen, onjuiste specificaties, verkeerd toegeschreven functionaliteit, incorrecte bedrijfshistorie. Het model reproduceert dan accuraat een bron die zelf niet klopt.
Het onderscheid is causaal en daarmee operationeel relevant. Hallucinaties zijn een platformeigenschap waar je als merkhouder weinig invloed op hebt. Feitelijke onjuistheden zijn terug te voeren op bronnen die je wel kunt corrigeren.
Het IAB stelt drie eisen aan beide. Rapporteren gebeurt per platform en niet als aggregaat, omdat percentages substantieel verschillen tussen modellen. De waarheidsbron moet door het merk worden aangeleverd. En gemarkeerde gevallen moeten aan de afnemer worden gerapporteerd, niet stilzwijgend uit de dataset verdwijnen. Het ontbreken van een gedocumenteerde detectiemethodiek geldt als materieel gebrek in elke kwaliteitsclaim, mede omdat gehallucineerde vermeldingen de Mention Rate opwaarts vertekenen en daarmee ook de Share of Voice en de sentimentanalyse aantasten.
Persuasion: leidt het tot gedrag
Recommendation Strength operationaliseert het verschil tussen actieve aanbeveling en passieve vermelding. De beoordeling weegt drie dingen: gebruikt het model specifieke, onderschrijvende formuleringen, hoe prominent staat de aanbeveling in het geheel, en is de aanbeveling voorwaardelijk of onvoorwaardelijk. Het verschil tussen een goede keuze als budget beperkend is en de beste optie. De grens is een beoordelingskeuze, en de gehanteerde rubriek moet openbaar zijn.
Post-Citation CTR is het aandeel vermeldingen dat leidt tot bezoek aan een eigen kanaal. Deze metric vormt de brug naar attributie en is afhankelijk van data die niet alle platforms vrijgeven. Het IAB classificeert hem voor de meeste implementaties als directional.
Drie dingen die nog niet standaardiseerbaar zijn
Competitive Displacement Rate, het aandeel antwoorden waarin jij voorkomt en een specifieke concurrent niet, heeft een probleem in de noemer. Afwezigheid van die concurrent kan betekenen dat het model jou verkoos, of dat de vraag de categorie niet activeerde. De metric onderscheidt die twee gevallen niet.
Attention Proxies benaderen aandacht binnen een antwoord via positie en tekstlengte rond de vermelding. Directional, en nog niet gevalideerd tegen bedrijfsuitkomsten.
Multimodal Visibility betreft representatie in gegenereerde beelden, spraakantwoorden en productkaarten. De meetinfrastructuur daarvoor is nog in ontwikkeling.
Directional of decision-grade: waar is dit cijfer goed genoeg voor
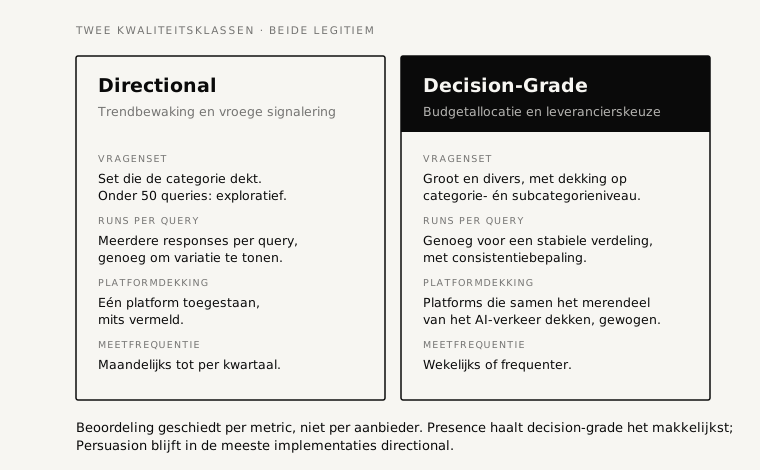
De tweede bijdrage van het framework is een tweedeling in geschiktheid. Beide klassen zijn legitiem. De fout die het framework wil voorkomen is dat directional data wordt behandeld alsof zij decision-grade is.
| Criterium | Directional | Decision-Grade |
|---|---|---|
| Toepassing | Trendbewaking, vroege signalering, interne briefing | Budgetallocatie, bureaubeoordeling, strategie, leverancierskeuze |
| Query-volume | Set die de categorie dekt. Onder 50 queries geldt een programma als exploratief, niet als directional | Grote, diverse set met dekking op categorie- en subcategorieniveau, met opgave van totaalvolume |
| Runs per query | Meerdere responses per query, voldoende om typische variatie te tonen | Voldoende voor een stabiele verdeling, met opgave van aantal en consistentiebepaling |
| Intentdekking | Minimaal twee van de vier types, met opgegeven verdeling | Alle vier: informatief, vergelijkend, aanbevelend, transactioneel, uitsplitsbaar gerapporteerd |
| Meetfrequentie | Maandelijks tot per kwartaal | Wekelijks of frequenter |
| Reproduceerbaarheid | Variatie toegestaan, mits gedocumenteerd | Vastgestelde bandbreedtes binnen een venster van 7 dagen, met betrouwbaarheidsniveaus en een vastgelegd verificatieproces |
| Platformdekking | Een platform toegestaan, mits vermeld | Platforms die samen het merendeel van het AI-verkeer in de doelmarkt dekken, met weging en onderbouwing |
| Aggregatie | Toegestaan, mits samenstelling vermeld | Per platform apart rapporteren, spreiding tonen, weging documenteren |
Twee nuances zijn belangrijk.
De klasse-indeling geldt niet uniform over metrics. Presence-metrics zijn al op directional schaal bruikbaar. Prominence en Portrayal bevatten beoordelingskeuzes die de variantie vergroten en stellen daarom hogere eisen aan reproduceerbaarheid. Persuasion-metrics hangen af van platformdata en blijven in de meeste implementaties directional. Je beoordeelt dus per metric, niet per aanbieder.
En directional data kan zwaardere conclusies dragen bij convergentie. Wanneer meerdere onafhankelijke signalen over meerdere meetperioden dezelfde kant op wijzen en worden bevestigd door je eigen analytics, is een zwaardere conclusie verdedigbaar. Niet verdedigbaar is een zwaar besluit op een meetperiode, of wanneer platforms of aanbieders elkaar tegenspreken.
De vragenset is de belangrijkste keuze
De constructie van de promptbibliotheek is volgens het IAB een van de meest consequentiele methodologische keuzes, en tegelijk een van de minst zichtbare voor de afnemer. Twee aanbieders die hetzelfde merk in dezelfde categorie meten, kunnen materieel verschillende uitkomsten produceren uitsluitend door verschillen in constructie, weging en verversing van hun vragenset.
Openbaar moet zijn: hoe de prompts gestructureerd zijn, hoe ze thematisch geclusterd zijn en of dat een sectorconventie volgt of een eigen taxonomie, hoe ze verdeeld zijn over de vier intenttypes, en waarop de selectie is gebaseerd. Met name of de vragen zijn afgeleid uit werkelijk zoekvolume, of synthetisch geconstrueerd.
Twee manieren waarop een meting scheef gaat
Prompt-gedreven vertekening treedt op wanneer de vragenset onevenwichtig is over vraagtypes, formuleringen of intenties, waardoor bepaalde merken sterker of zwakker lijken dan bij een representatieve steekproef. Een set met te veel aanbevelingsvragen bevoordeelt merken die daar sterk in zijn en onderschat hun prestatie bij informatieve of vergelijkende vragen. Het correctiemechanisme is transparantie: publicatie van de prompttaxonomie en de verdeling, zodat de afnemer kan beoordelen of de set overeenkomt met werkelijk gebruikersgedrag.
Platform-gedreven vertekening treedt op wanneer de trainingsdata of het antwoordgedrag van een platform bepaalde merken systematisch bevoordeelt of benadeelt, los van hun werkelijke marktpositie. Je detecteert dat door kruisvergelijking met identieke vragensets over meerdere platforms. Het correctiemechanisme is gescheiden rapportage per platform, zodat platformspecifieke patronen zichtbaar blijven in plaats van weg te middelen.
De ontwerpregel: niet over jezelf beginnen
Merkgebonden vragen mogen niet domineren. Ze zijn bruikbaar voor reputatiemeting en voor het toetsen van beschrijvingsaccuratesse, maar ze vertekenen het zichtbaarheidscijfer opwaarts. De commercieel relevante grootheid is of het merk verschijnt voordat de gebruiker de naam kent. Twee tot drie natuurlijke parafrasen per belangrijke intentie zijn zinvol. Honderden bijna-duplicaten om het volume op te krikken zijn dat niet.
Een meting is geen meting
Generatieve systemen produceren geen deterministische output. Dezelfde vraag levert bij herhaling andere antwoorden op, met andere merken, andere bronnen en andere framing. Dat is inherent aan de manier waarop taalmodellen tekst genereren, en het is er niet uit te ontwerpen.
Het IAB leidt daar twee ontwerpconsequenties uit af.
Enkelvoudige meting is geen meting. Zichtbaarheid op een query is een verdeling, geen waarde. Een metric op basis van een respons per query is een steekproef van omvang een.
En waargenomen verandering moet worden onderscheiden van inherente variabiliteit. Een verschuiving van vier punten in Share of Voice is alleen betekenisvol als zij de variatie overstijgt die ontstaat bij herhaling van dezelfde queries op hetzelfde platform op dezelfde dag. Zonder gedocumenteerde variabiliteitsbaseline is trendinterpretatie niet onderbouwd.
Wat het onderzoek laat zien
SE Ranking legde 10.000 keywords driemaal op een dag voor aan Google AI Mode. Over 122.617 links bedroeg de gemiddelde overlap van exacte URL’s tussen de drie passages 9,2 procent. Bij 2.006 keywords, 21,2 procent van de set, kwam geen enkele URL terug.
Schulte en collega’s van de Universiteit St. Gallen volgden ChatGPT, Perplexity, Gemini en Google AI Mode gedurende 45 dagen. Geciteerde bronnen wisselden dagelijks voor ongeveer 65 procent. Identieke prompts die op hetzelfde moment werden herhaald, overlapten op geciteerde bronnen slechts 32 tot 43 procent. De instabiliteit komt dus overwegend voort uit het probabilistische karakter van de output, niet uit tijdsverloop. Dezelfde studie rapporteert een gemiddelde Gini-coefficient van 0,715 voor bronconcentratie, wat wijst op sterke concentratie van citaties bij een klein aantal domeinen.
Uit de convergentieanalyse van diezelfde studie volgt een operationele ondergrens: detectiecijfers per merk zijn interpreteerbaar vanaf 7 runs per prompt per dag, en trends per merk vanaf voortschrijdende vensters van 2 tot 4 weken.
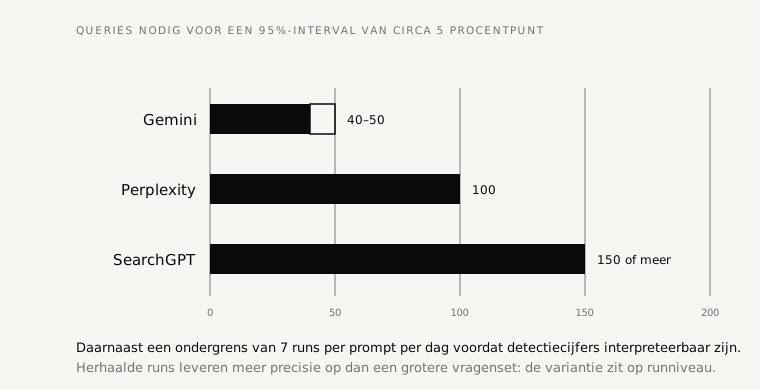
Sielinski kwantificeert de benodigde omvang voor een 95 procent-betrouwbaarheidsinterval van ongeveer vijf procentpunt breed: ongeveer 40 tot 50 queries op Gemini, ongeveer 100 op Perplexity, en 150 of meer op SearchGPT, dat minder bronnen per antwoord citeert en daarmee de grootste ruis kent. De studie concludeert bovendien dat veel schijnbare verschillen tussen domeinen binnen de ruisondergrens van het meetproces vallen.
Herhaalde runs dragen meer bij aan precisie dan uitbreiding van de vragenset, omdat de variantie op runniveau zit. Een set van 50 prompts die tien keer wordt uitgevoerd is informatiever over stabiliteit dan 500 prompts die een keer worden uitgevoerd.
En dan het cijfer dat het meest zegt over de staat van deze markt: van acht vergeleken aanbieders documenteerde er in april 2026 een publiekelijk betrouwbaarheidsintervallen en steekproefomvang.
Het IAB onthoudt zich bewust van vaste kwantitatieve drempels. Acceptabele variabiliteit verschilt per metric, platform en vraagtype, en dat blijft een openstaande vraag binnen de werkgroep. Wat wel verplicht is: meting van de variatie over herhaalde identieke queries binnen een vastgesteld venster, en zichtbaarheid van die variatie in de rapportage.
Waar en wanneer je meet, verandert wat je meet
Geografische variatie ontstaat door platformbeschikbaarheid, modelroutering, regionale contentvoorkeuren en lokalisatie van antwoorden. Een vraag gesteld vanuit Nederland en dezelfde vraag gesteld vanuit de Verenigde Staten leveren andere merken, andere bronnen en andere framing op, ook bij woordelijk identieke formulering.
De eis van het IAB is dienovereenkomstig: programma’s die meerdere markten bestrijken moeten de geografische herkomst van de queries vermelden en per markt rapporteren, zonder aggregatie tot een score. Vergelijking tussen markten op decision-grade niveau vereist bovendien vraagontwerp dat is aangepast aan lokale taal en formulering.
Voor de Nederlandse markt is de implicatie direct. Een dienst die vanuit een niet-Nederlandse locatie meet en een Nederlands cijfer rapporteert, schat een andere grootheid dan de zichtbaarheid die de Nederlandse gebruiker ondervindt.
Temporele variatie ontstaat door platformupdates, verversingscycli van de index en patronen over de dag en de week. Queries horen op consistente cadans en waar mogelijk op consistente tijdstippen te worden uitgevoerd. Verzamel je over een venster, dan moet dat venster gedocumenteerd zijn en tussen meetperioden vergelijkbaar blijven.
Modeldrift: wanneer je de nullijn opnieuw zet
Platforms actualiseren hun modellen op momenten die niet altijd publiek worden aangekondigd, en zulke updates kunnen zichtbaarheidsmetrics onmiddellijk en materieel verschuiven. Een verschuiving van vijf punten in Share of Voice is mogelijk zonder enige verandering in het merk of zijn concurrentiepositie.
Daar komt recency bias bij: modellen wegen recentere content zwaarder. Zichtbaarheid kan dus dalen doordat retrieval of training recentere bronnen prefereert, niet doordat je positie is verzwakt. Dat is een systematische driftvorm die de vergelijkbaarheid over tijd aantast, en die als vaste baselinevariabele gedocumenteerd hoort te worden. Zeker bij evergreen content en bij meting over hertrainingscycli heen.
Het onderscheiden van platform-gedreven en markt-gedreven verschuivingen is volgens het IAB de centrale taak van elk stabiel meetprogramma. Programma’s die dat nalaten, rapporteren modelgedrag als merkprestatie.
Hoe je het uit elkaar houdt
| Dimensie | Platform-gedreven | Markt-gedreven |
|---|---|---|
| Patroon | Zichtbaar bij meerdere merken of de hele categorie op hetzelfde platform | Beperkt tot specifieke merken of specifieke vraagtypen |
| Oorzaak | Modelupdate, gewijzigde retrievalconfiguratie, gewijzigd rangordegedrag of antwoordformaat | Campagne, nieuwe toetreder, content die tractie krijgt |
| Vorm | Abrupt, buiten de normale variabiliteitsbandbreedte | Geleidelijk of gebonden aan een gebeurtenis |
Voordat je concludeert dat een schok platform-gedreven is, moet je drie alternatieve verklaringen uitsluiten: eigen merkactiviteit, concurrentieactiviteit, en wijzigingen in de eigen vragenset. Daarna volgt een drietrapsprocedure: controle van de gepubliceerde release notes, vergelijking van het getroffen platform met de overige platforms in het programma, en analyse of de verschuiving geconcentreerd is in specifieke intenttypes dan wel gelijkmatig verdeeld.
De sterkste indicatie voor een platformoorzaak is het patroon over de categorie. Een abrupte verandering die bij meerdere merken op hetzelfde platform optreedt, weerspiegelt vrijwel altijd modelgedrag. Merkspecifieke verschuivingen die geconcentreerd zijn in bepaalde vraagtypen weerspiegelen vrijwel altijd echte prestatieverandering.
Wanneer je reset
Niet elke update rechtvaardigt een reset. Kleine wijzigingen vallen binnen de normale variabiliteit. Een reset is aangewezen bij:
- een door het platform aangekondigde majeure modelversie;
- wijziging in citatiegedrag, antwoordformaat of presentatie van het antwoordoppervlak, inclusief plaatsing van citaties, kaartformaten, bronnenlades, standaard in- of uitgeklapte weergave, mobiele layout en de introductie van gesponsorde modules, ook wanneer de gegenereerde tekst ongewijzigd blijft;
- wijziging van de vragenset waardoor vergelijkbaarheid met voorgaande perioden breekt.
Bij een reset documenteer je de aanleiding, de datum en de aard van de wijziging, voer je het programma opnieuw uit om een nieuwe nullijn vast te stellen, en rapporteer je de perioden voor en na de reset als afzonderlijke reeksen. Trendmetrics als Visibility Momentum zijn alleen interpreteerbaar bij een stabiele of expliciet gereset nullijn.
Wanneer je een platform toevoegt
Opname van een platform is gerechtvaardigd zodra het genoeg AI-verkeer in de doelmarkt vertegenwoordigt om het zichtbaarheidsbeeld materieel te beinvloeden. Daaronder voegt het meer ruis dan signaal toe, en is monitoring passender dan meting. Datzelfde aandeel vormt de grondslag voor weging: een platform dat 40 procent van de categoriequeries afhandelt weegt zwaarder dan een platform met 5 procent, en een gecombineerde score hoort die asymmetrie te weerspiegelen.
Het IAB erkent dat de beschikbare data over AI-gebruiksaandelen fragmentarisch is en niet direct vergelijkbaar tussen platforms. De norm is daarom een gedocumenteerde, consistent toegepaste methodiek in plaats van een vaste drempel, met gebruik van meerdere bronnen waar mogelijk: platformrapportage, meting door derden, en je eigen verwijzingsanalytics.
Toevoegen doe je op vast schema, niet reactief, en je behandelt het als baselinegebeurtenis: nieuwe nullijn inclusief het toegevoegde platform, behoud van de oude nullijn voor historische vergelijking, en parallelle rapportage op beide grondslagen totdat de nieuwe genoeg historie heeft voor trendanalyse.
Hoe je rapporteert als de data probabilistisch is
AI-zichtbaarheidsdata is probabilistisch en gevoelig voor vraagsamenstelling, modelversie en platformgedrag. Rapporteren volgens de conventies van deterministische zoekmetrics wekt verwachtingen die de data niet kan waarmaken.
Het IAB benoemt dat als communicatieprobleem: een lezer die twee decennia Google-cijfers als exacte waarden heeft gelezen, leest een bandbreedte als onnauwkeurigheid, tenzij het rapport actief het interpretatiekader herstelt.
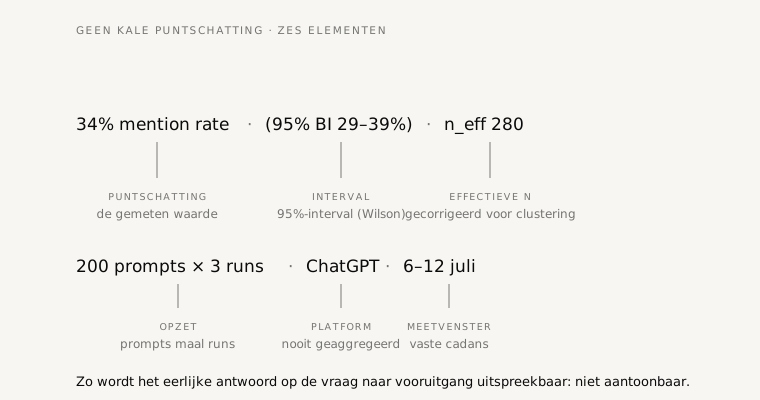
Een Share of Voice gerapporteerd als circa 22 procent, met een bandbreedte van vier punten bij de huidige meetprecisie, is informatiever voor een beslisser dan een kale 22 procent, die een precisie suggereert die de meting niet bezit.
Het praktische voordeel van dit format is dat het het eerlijke antwoord op de vraag naar vooruitgang uitspreekbaar maakt: niet aantoonbaar.
Vier situaties, vier manieren om het te zeggen
Het framework levert formuleringen als startpunt, niet als script. Vrij vertaald:
Bij het introduceren van de data. Vestig eerst het kader, dan het cijfer. AI-platforms geven niet bij elke herhaling hetzelfde antwoord op dezelfde vraag; daarom rapporteren wij bandbreedtes in plaats van losse waarden. De bandbreedte representeert normale variatie. Verandering binnen die bandbreedte is niet betekenisvol, verandering erbuiten wel.
Bij een platform-gedreven verschuiving. Benoem de oorzaak direct en meld of de nullijn wordt gereset. De zichtbaarheid daalde circa zes punten. De daling valt samen met een bevestigde modelupdate en een vergelijkbare orde van grootte is zichtbaar bij concurrenten in dezelfde categorie. Dit leest als platformverschuiving, niet als merkspecifiek prestatiesignaal. Wij behandelen dit als reset en rapporteren de perioden voor en na afzonderlijk tot de nieuwe nullijn stabiliseert.
Bij een aanhoudende daling na platformstabilisatie. Verschuif de duiding expliciet. De daling in de voorgaande periode werd aanvankelijk toegeschreven aan een modelupdate. Het platform is inmiddels gestabiliseerd en de daling houdt over twee opeenvolgende meetperioden aan. Wij lezen dit nu als prestatiesignaal in plaats van platformruis en adviseren nader onderzoek.
Bij divergerende platformresultaten. Forceer geen synthese. Zichtbaarheid op platform A steeg vier punten, op platform B daalde zij drie punten. De divergentie is niet herleidbaar tot een trend. Wij rapporteren per platform en behandelen elk traject afzonderlijk voor deze periode.
Heldere causale toeschrijving is een kerntaak van het meetprogramma. Het verschil tussen de zichtbaarheid daalt en de zichtbaarheid daalt vanwege een platformupdate die nog niet is gestabiliseerd, is het verschil tussen een strategische reactie en geen reactie.
Over samengestelde scores
Meerdere metrics aggregeren tot een index mag, en is bruikbaar voor het volgen van de grote lijn, maar bevat wegingskeuzes die de uitkomst materieel bepalen. Het IAB stelt vier eisen: openbaarmaking van de volledige weging, van de normalisatiemethode, van de afzonderlijke metricwaarden die de index voeden, en van de beperkingen van de aggregatiebenadering.
De positie van het framework is ondubbelzinnig. De componentmetrics vormen de gezaghebbende meetwoordenschat. De samengestelde score is presentatielaag, en de onderliggende data moet te allen tijde toegankelijk blijven.
Wat je een aanbieder moet vragen
Het IAB definieert de minimale informatie die je als afnemer nodig hebt om geschiktheid te beoordelen. Waar een aanbieder niet kan of wil antwoorden, geldt die afwezigheid zelf als signaal.
Wat wordt gemeten
- Platformdekking, met specificatie van modelversies.
- Constructie van de promptbibliotheek: omvang, structuur, verversingscadans, totaal queryvolume, verdeling over categorieen, weging binnen de bibliotheek, en of prompts getoetst zijn over uiteenlopende demografische en culturele formuleringen.
- Herkomst van de queries: synthetisch geconstrueerd, afgeleid uit werkelijk zoekvolume, ontleend aan waargenomen gebruikersgedrag, of een combinatie. Bij praktijkdata: bron en selectie- of wegingsprocedure.
- Classificatie van brontypen, zoals merkeigen, retailer, redactionele uitgever of instituut, en de weging daarvan in de output.
Hoe wordt gemeten
- Verzamelarchitectuur: actieve querysimulatie, passieve gedragsobservatie via een opt-in panel, platform-eigen data, of een hybride vorm. Output uit verschillende architecturen mag niet als gelijkwaardig worden gepresenteerd zonder expliciete vermelding.
- Toegangsmethode: officiele API’s, gelicentieerde datafeeds, browserobservatie, gebruikerspanels, synthetische sessies of geautomatiseerde scraping, met opgave of die methode voldoet aan platformvoorwaarden en limieten.
- Retrievalconfiguratie: worden queries uitgevoerd met live webretrieval aan, uit, of beide. Resultaten onder verschillende configuraties mogen niet zonder vermelding worden samengevoegd.
- Panelvaliditeit bij passieve observatie: omvang, wervingsmethodiek, incentivestructuur en demografische representativiteit ten opzichte van de doelpopulatie van AI-gebruikers. Kleine of smal geworven panels leveren signalen die niet generaliseerbaar zijn.
- Datavalidatie: tegen welke externe signalen wordt gevalideerd, hoe wordt vergelijkbaarheid geborgd bij meerdere bronnen, welke controles gelden voor steekproefintegriteit inclusief uitschieters en entiteitsdisambiguatie, hoe wordt de nullijn vastgesteld, en wat zijn de bekende beperkingen.
- Detectiemethodiek voor hallucinaties en feitelijke onjuistheden, en of gemarkeerde gevallen worden gerapporteerd dan wel gefilterd.
Hoe de data wordt onderhouden
- Beschikbare historie, verwerking van modelupdates in die historie, en of trenddata na platformwijzigingen opnieuw is gebaseline’d, inclusief documentatie van het triggerende voorval.
Het IAB onderscheidt twee niveaus. Minimale openbaarmaking omvat platformdekking, verzamelarchitectuur, constructie van de promptbibliotheek op hoofdlijnen, en de logica achter toeschrijving en sentiment op hoofdlijnen. Dat volstaat voor directional toepassing en toont aan dat er een samenhangende methodiek bestaat.
Uitgebreide openbaarmaking omvat alle bovenstaande punten in volledige documentatiediepte. Dat is de verwachting voor elke aanbieder wiens output als decision-grade wordt gepositioneerd of wordt gebruikt voor budgetallocatie, leverancierskeuze of directierapportage.
Het advies is om het vereiste niveau af te stemmen op het besluit dat je met de data neemt, en de bereidheid tot uitgebreide openbaarmaking te lezen als indicator van methodologisch vertrouwen. Het kader is uitdrukkelijk bedoeld als grondslag voor een mogelijk toekomstig certificeringsprogramma.
Wat dit betekent voor het Nederlandse MKB
AI is veel selectiever dan Google. SOCi analyseerde prestatiedata van bijna 350.000 vestigingen verspreid over 2.751 multi-locatiemerken. Het aandeel vestigingen dat werd aanbevolen bedroeg 1,2 procent bij ChatGPT, 11 procent bij Gemini en 7,4 procent bij Perplexity, tegenover 35,9 procent zichtbaarheid in de lokale 3-pack van Google. SOCi schat AI-zichtbaarheid daarmee drie tot dertig maal moeilijker te bereiken dan een goede positie in klassieke lokale zoekresultaten.
Je lokale SEO-prestatie draagt maar half over. De overlap tussen merken die leidend zijn in lokale Google-zichtbaarheid en merken die tot de meest zichtbare in AI-resultaten behoren, bedraagt minder dan de helft. Voor retail rapporteert SOCi 45 procent. Lokale zoekprestatie is dus geen betrouwbare voorspeller van AI-zichtbaarheid. Dat is een empirische bevinding, geen stelling.
De accuratesse van je bedrijfsgegevens verschilt per platform. SOCi rapporteert circa 68 procent accuratesse van bedrijfsprofielinformatie bij ChatGPT en Perplexity, tegenover 100 procent bij Gemini, dat gefundeerd is op Google Maps. Voor het Nederlandse MKB, waar verouderde vermeldingen in directories wijdverbreid zijn, maakt dat de Factual Inaccuracy Rate tot de metric met de kortste weg naar een uitvoerbare interventie.
Je hebt een kleinere steekproef nodig dan een landelijk merk. Lokale queries leveren kortere shortlists op met stabielere samenstelling. Waargenomen percentages liggen daardoor dichter bij 0 of 100 procent, waar de binomiale variantie het laagst is.
Vraag als eerste waar er gemeten wordt. Bij de keuze van een dienstverlener is de eerste vraag niet hoeveel platforms worden gedekt, maar vanuit welke markt wordt gemeten, in welke taal de queries zijn geformuleerd, en of er per markt wordt gerapporteerd.
Wat dit betekent voor de 21x-methode
Onze meetmethode is ontwikkeld voordat deze standaard bestond. Nu er een extern referentiekader ligt, is een expliciete toetsing op zijn plaats: welke ontwerpkeuzes worden bevestigd, en welke moeten worden aangescherpt.
Wat het framework bevestigt
Meten zonder ingelogde sessie. Wij meten consequent uitgelogd. Het IAB benoemt personalisatie en sessiestaat als variabelen die gecontroleerd en vermeld moeten worden. Meten vanuit een account met interactiehistorie schat een andere grootheid: herkenning binnen een gepersonaliseerde context, niet zichtbaarheid voor een onbekende gebruiker.
De vraag op categorieniveau, zonder merknaam. Onze scan stelt de vraag zoals een klant hem stelt die je nog niet kent. Het IAB stelt vast dat merkgebonden prompts de zichtbaarheidsmetriek opwaarts vertekenen, en dat de commercieel relevante grootheid is of het merk verschijnt voordat de gebruiker de naam kent. Die keuze is daarmee onafhankelijk bevestigd.
Share of voice tegen een expliciet afgebakende concurrentieset. Dit correspondeert met de Presence-metric zoals het IAB die definieert, inclusief de eis dat de concurrentieset en de noemer expliciet worden gemaakt.
Een vastgelegd protocol. Het 34-punts protocol over zes blokken vervult de functie die het IAB als methodologiedocumentatie aanmerkt. De praktische waarde ligt in vergelijkbaarheid over tijd: definitiedrift is een dominante foutbron in deze discipline, en een bevroren protocol elimineert die bron.
Meten op het gerenderde antwoordoppervlak. Meten in de interface in plaats van via de API is precies het onderscheid dat het IAB onder verzamelarchitectuur laat specificeren, en het correspondeert met de Position-eis om te meten wat de gebruiker ziet in plaats van de ruwe modeloutput.
Wat wij aanscherpen
Herhaalde runs met intervalschatting. Rapportage geschiedt voortaan als puntschatting met betrouwbaarheidsinterval en opgave van de steekproefopzet, in het zesledige format hierboven, met Wilson score-intervallen gezien de proportionele aard van de uitkomstvariabele.
Gescheiden rapportage per platform, gewogen naar Nederlands gebruiksaandeel. Geen gecombineerde score die divergentie tussen platforms wegmiddelt.
Toevoeging van de Portrayal-laag. Hallucinaties en feitelijke onjuistheden worden afzonderlijk gemeten en aan de klant gerapporteerd in plaats van gefilterd, met de merkeigen data als waarheidsbron.
Expliciete klassevermelding. Elk rapport vermeldt op de eerste pagina of de meting directional of decision-grade is, en voor welke besluittypen zij geschikt is.
Een afbakening die we niet willen laten vervagen
Eén verduidelijking is hier op zijn plaats, omdat de twee onderzoekslijnen regelmatig door elkaar worden gehaald. De bevindingen over effectieve optimalisatiemethoden, waaronder het toevoegen van geattribueerde citaten en statistieken, komen uit Aggarwal e.a. (KDD 2024) en niet uit het IAB-framework. Het IAB sluit optimalisatiemethodiek expliciet uit van zijn reikwijdte. Meten en optimaliseren zijn hier gescheiden onderzoeksobjecten, en het framework valideert alleen het eerste.
Wat deze manier van meten niet kan
Volledigheidshalve de belangrijkste beperkingen.
De doelgrootheid blijft onobserveerbaar. Geen enkel programma observeert werkelijke gebruikersgesprekken. Alle scores zijn schattingen binnen een geconstrueerd steekproefkader.
De vragenset is een doelgerichte, geen aselecte steekproef. Externe validiteit rust op de aanname dat de set gebruikersgedrag representeert. Die aanname is toetsbaar tegen zoekvolumedata, maar zelden volledig verifieerbaar.
Variabiliteitsdrempels zijn niet vastgesteld. Het IAB laat expliciet open welke variatie acceptabel is per metric, platform en vraagtype. Wat vandaag als decision-grade geldt, is een werkafspraak, geen empirisch gevalideerde grens.
Zichtbaarheid is geen rendement. De Persuasion-laag is de enige die gedrag raakt, en die is voor de meeste implementaties directional wegens ontbrekende platformdata. Elke gelijkstelling van zichtbaarheid aan bedrijfsresultaat is op dit moment een aanname, geen meting.
Meting geeft geen causale identificatie. Een waargenomen stijging na een interventie is geen bewijs van effect: modeldrift, recency bias, concurrentiegedrag en herbaselining zijn concurrerende verklaringen. Wie causale uitspraken wil doen, heeft een controlegroep nodig of een tijdreeksopzet met een contrafeitelijke schatting, en geen van beide is in commerciele praktijk gebruikelijk.
Veelgestelde vragen
Wat is AI-zichtbaarheid?
De mate waarin en de wijze waarop een merk voorkomt in door AI-systemen gegenereerde antwoorden, geschat over een gedefinieerde vragenset en platformselectie.
Hoeveel vragen zijn minimaal nodig?
Onder 50 queries per meetprogramma classificeert het IAB de meting als exploratief, niet als directional. Voor decision-grade meting is een grote, diverse set vereist met dekking op categorie- en subcategorieniveau.
Hoe vaak moet dezelfde vraag worden herhaald?
Meer dan een keer, met een platformafhankelijk aantal. Schulte e.a. leiden uit convergentieanalyse een ondergrens van 7 runs per prompt per dag af voor interpreteerbare detectiecijfers per merk. Sielinski rapporteert voor een interval van circa vijf procentpunt breed ongeveer 40 tot 50 queries op Gemini, circa 100 op Perplexity en 150 of meer op SearchGPT. Het IAB stelt geen vast getal, maar verplicht wel documentatie van de waargenomen variatie.
Hoe vaak moet er worden gemeten?
De cadans dient de besliscyclus te volgen en niet te overtreffen. Maandelijks voor trendbewaking, tweewekelijks tot wekelijks voor concurrentievergelijking en bureaurapportage, wekelijks of frequenter voor budgetallocatie. Wekelijks meten voor een kwartaalbesluit levert data op die volatieler is dan bruikbaar.
Is een platform voldoende?
Voor directional meting wel, mits vermeld. Voor decision-grade meting moeten de gemeten platforms samen het merendeel van het AI-verkeer in de doelmarkt vertegenwoordigen, met gescheiden rapportage per platform.
Waarom mogen platforms niet worden samengevoegd tot een score?
Omdat de uitkomst per platform substantieel verschilt voor hetzelfde merk. Aggregatie verbergt precies de variatie die je operationeel kunt gebruiken. Een samengestelde index mag, mits weging, normalisatie, componentwaarden en beperkingen openbaar zijn en de onderliggende data toegankelijk blijft.
Het cijfer daalde abrupt. Hoe duid je dat?
Onderzoek eerst of de daling ook optreedt bij concurrenten in dezelfde categorie op hetzelfde platform. Zo ja, dan is een modelupdate de meest waarschijnlijke verklaring. Zo nee, en is de daling geconcentreerd in specifieke intenttypes, dan is een merkspecifieke prestatieverklaring waarschijnlijker.
Is een internationaal gemeten cijfer geldig voor een Nederlandse onderneming?
Nee. Identieke queries leveren vanuit verschillende markten andere merken en bronnen op. Het IAB verplicht rapportage per markt zonder aggregatie.
Dekt het framework betaalde plaatsingen?
Nee. De reikwijdte is beperkt tot organische, onbetaalde zichtbaarheid. Betaalde plaatsing en downstream-attributie zijn benoemd als openstaande gebieden voor vervolgstandaardisatie.
Bronnen
- IAB, Measuring Visibility in the AI Era, augustus 2026. Volledig framework met metricdefinities, criteriamatrix, openbaarmakingskader en stabiliteitsprotocollen. Onderdeel van Project Eidos.
- Schulte, J. e.a., Don’t Measure Once: Measuring Visibility in AI Search (GEO), arXiv 2604.07585, Universiteit St. Gallen, 2026. Longitudinale meting over vier engines, 45 dagen; convergentieanalyse, Jaccard- en RBO-stabiliteitsmaten, Gini-concentratie van citaties.
- Sielinski, Quantifying Uncertainty in AI Visibility, arXiv, 2026. Bootstrap-betrouwbaarheidsintervallen en benodigde steekproefomvang per engine.
- Aggarwal, P., Murahari, V., Rajpurohit, T., Kalyan, A., Narasimhan, K., Deshpande, A., GEO: Generative Engine Optimization, KDD 2024, arXiv 2311.09735. Introductie van Position-Adjusted Word Count en Subjective Impression; GEO-bench.
- SOCi, Local Visibility Index 2026. Bijna 350.000 vestigingen, 2.751 multi-locatiemerken; aanbevelingspercentages en profielaccuratesse per platform.
- SE Ranking, herhaalbaarheidsonderzoek Google AI Mode, 10.000 keywords, 122.617 links, drie passages op een dag.
- SeniorWeb, onderzoek naar AI-gebruik in Nederland.